Semantic Segmentation Fine Tuning Inference
在自定义数据集上微调语义分割模型并通过推理 API 使用
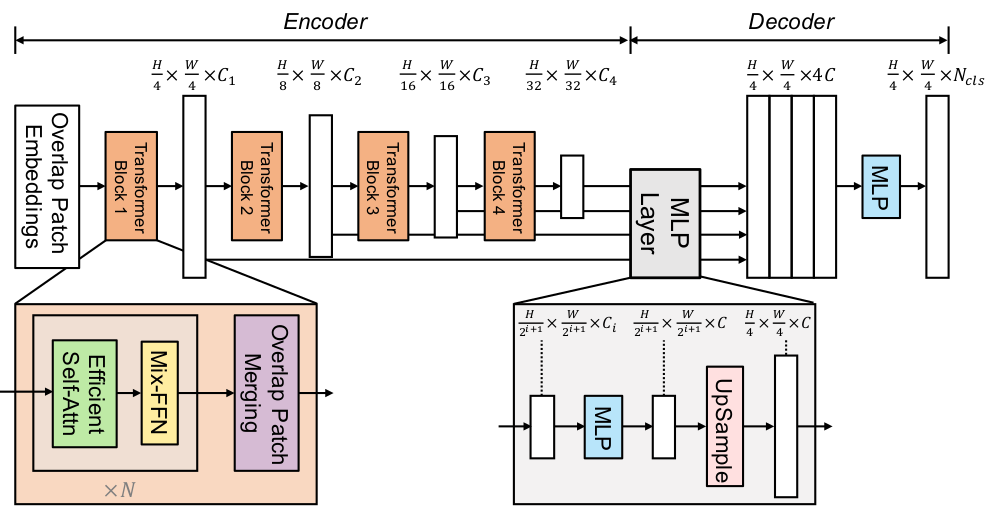
在本 Notebook 中,我们将介绍如何在自定义数据集上微调一个 语义分割 模型。我们将使用的模型是预训练的 Segformer,这是一个强大且灵活的基于 Transformer 的分割架构,适用于各种分割任务。
对于我们的数据集,我们将使用 segments/sidewalk-semantic,它包含了标注好的人行道图像,十分适合用于城市环境中的应用。
示例应用场景:
该模型可以部署在送餐机器人中,使其能够自动在城市人行道上导航,将披萨直接送到您家门口 🍕。
一旦我们微调完成该模型,接下来会演示如何使用 Serverless 推理 API 将模型部署,使其可以通过一个简单的 API 端点进行访问。
1. 安装依赖
首先,我们需要安装微调语义分割模型所需的必要库。以下是安装依赖的步骤:
2. 加载数据集 📁
我们将使用 sidewalk-semantic 数据集,该数据集包含了 2021 年夏季在比利时收集的关于人行道的图像。
该数据集包括:
- 1,000 张图像及其对应的语义分割掩膜 🖼
- 34 个不同的类别 📦
由于该数据集是受限访问的,你需要登录并接受许可才能访问。同时,我们还需要身份验证来上传微调后的模型到 Hugging Face Hub。
审查数据集的内部结构以熟悉它!
DatasetDict({
, train: Dataset({
, features: ['pixel_values', 'label'],
, num_rows: 1000
, })
,}) 由于数据集仅包含训练集,我们将手动将其分为 训练集 和 测试集。我们将 80% 的数据分配用于训练,剩余的 20% 用于评估和测试。 ➗
让我们检查一个示例中存在的对象类型。我们可以看到,pixels_values 包含了 RGB 图像,而 label 包含了 ground truth mask。ground truth mask 是一个单通道图像,其中每个像素表示对应 RGB 图像中像素的类别。
{'pixel_values': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=1920x1080>,
, 'label': <PIL.PngImagePlugin.PngImageFile image mode=L size=1920x1080>} 3. 可视化示例! 👀
现在我们已经加载了数据集,让我们可视化一些示例以及它们的掩膜,以便更好地理解数据集的结构。
数据集包含一个 JSON 文件,该文件包含了 id2label 映射。我们将打开这个文件,读取与每个 ID 关联的类别标签。
id2label.json: 0%| | 0.00/852 [00:00<?, ?B/s]
Id2label: {0: 'unlabeled', 1: 'flat-road', 2: 'flat-sidewalk', 3: 'flat-crosswalk', 4: 'flat-cyclinglane', 5: 'flat-parkingdriveway', 6: 'flat-railtrack', 7: 'flat-curb', 8: 'human-person', 9: 'human-rider', 10: 'vehicle-car', 11: 'vehicle-truck', 12: 'vehicle-bus', 13: 'vehicle-tramtrain', 14: 'vehicle-motorcycle', 15: 'vehicle-bicycle', 16: 'vehicle-caravan', 17: 'vehicle-cartrailer', 18: 'construction-building', 19: 'construction-door', 20: 'construction-wall', 21: 'construction-fenceguardrail', 22: 'construction-bridge', 23: 'construction-tunnel', 24: 'construction-stairs', 25: 'object-pole', 26: 'object-trafficsign', 27: 'object-trafficlight', 28: 'nature-vegetation', 29: 'nature-terrain', 30: 'sky', 31: 'void-ground', 32: 'void-dynamic', 33: 'void-static', 34: 'void-unclear'}
让我们为每个类别分配颜色 🎨。这将帮助我们更有效地可视化分割结果,并使得在图像中解释不同类别变得更加容易。
我们可以可视化数据集中的一些示例,包括 RGB 图像、对应的掩膜以及掩膜覆盖在图像上的效果。这将帮助我们更好地理解数据集以及掩膜如何与图像对应。📸


4. 可视化类别分布 📊
为了更深入地了解数据集,让我们绘制每个类别的出现次数。这将帮助我们理解各类别的分布情况,并识别数据集中的潜在偏差或不平衡问题。

5. 初始化图像处理器并使用 Albumentations 添加数据增强 📸
我们将首先初始化图像处理器,然后使用 Albumentations 应用数据增强 🪄。这将有助于增强我们的数据集,并提高语义分割模型的性能。
The cache for model files in Transformers v4.22.0 has been updated. Migrating your old cache. This is a one-time only operation. You can interrupt this and resume the migration later on by calling `transformers.utils.move_cache()`.
0it [00:00, ?it/s]
6. 从检查点初始化模型
我们将使用来自检查点的预训练 Segformer 模型:nvidia/mit-b0。该架构在论文 SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers 中有详细描述,并且已在 ImageNet-1k 数据集上进行训练。
7. 设置训练参数并连接到 Weights & Biases (W&B) 📉
接下来,我们将配置训练参数,并连接到 Weights & Biases (W&B)。W&B 将帮助我们跟踪实验、可视化指标,并管理模型训练工作流,在整个过程中提供有价值的洞察。
8. 设置自定义 compute_metrics 方法以增强使用 evaluate 的日志记录
我们将使用 平均交并比 (mean IoU) 作为评估模型性能的主要指标。这将使我们能够详细跟踪每个类别的性能。
此外,我们将调整评估模块的日志记录级别,以减少输出中的警告。如果图像中没有检测到某个类别,你可能会看到类似以下的警告:
RuntimeWarning: invalid value encountered in divide iou = total_area_intersect / total_area_union
如果你希望跳过这些警告并继续执行后续步骤,可以跳过此单元。
9. 在我们的数据集上训练模型 🏋
现在是时候在我们的自定义数据集上训练模型了。我们将使用已经准备好的训练参数,并通过连接的 Weights & Biases 集成来监控训练过程,并根据需要进行调整。让我们开始训练,并观察模型如何提高其性能!
10. 在新图像上评估模型性能 📸
训练完成后,我们将评估模型在新图像上的表现。我们将使用一张测试图像,并利用 pipeline 来评估模型在未见过的数据上的表现。

模型已经生成了一些掩码,我们可以可视化这些掩码以评估和理解其性能。这将帮助我们查看模型在图像分割上的表现如何,并识别需要改进的地方。

11. 在测试集上评估性能 📊
12. 使用推理 API 访问模型并可视化结果 🔌
Hugging Face 🤗 提供了一个 无服务器推理 API,允许你通过 API 端点直接测试模型,且可以免费使用。有关如何使用该 API 的详细指导,请参阅这个 指南。
我们将利用这个 API 来探索其功能,并看看它如何帮助我们测试模型。
重要提示
在使用无服务器推理 API 之前,你需要通过创建模型卡来设置模型任务。在为你的微调模型创建模型卡时,确保正确指定任务。

一旦模型任务设置完成,我们可以下载一张图片并使用 InferenceClient 来测试模型。这个客户端将允许我们通过 API 将图片发送到模型,并获取结果以进行评估。
我们将使用 InferenceClient 的 image_segmentation 方法。该方法接受模型和图片作为输入,并返回预测的掩码。这将帮助我们测试模型在新图片上的表现。
通过预测的掩码,我们可以展示结果。
/usr/local/lib/python3.10/dist-packages/huggingface_hub/inference/_generated/types/base.py:139: FutureWarning: Accessing 'ImageSegmentationOutputElement' values through dict is deprecated and will be removed from version '0.25'. Use dataclass attributes instead. warnings.warn(