RAG 评估
本 notebook 演示了如何评估你的 RAG(Retrieval Augmented Generation),通过构建一个合成评估数据集并使用 LLM-as-a-judge 来计算你系统的准确性。
对于 RAG 系统的介绍,你可以查看这个技术指南!
RAG 系统很复杂: 这里有一个 RAG 流程图,我们用蓝色标注了系统增强的所有可能性:
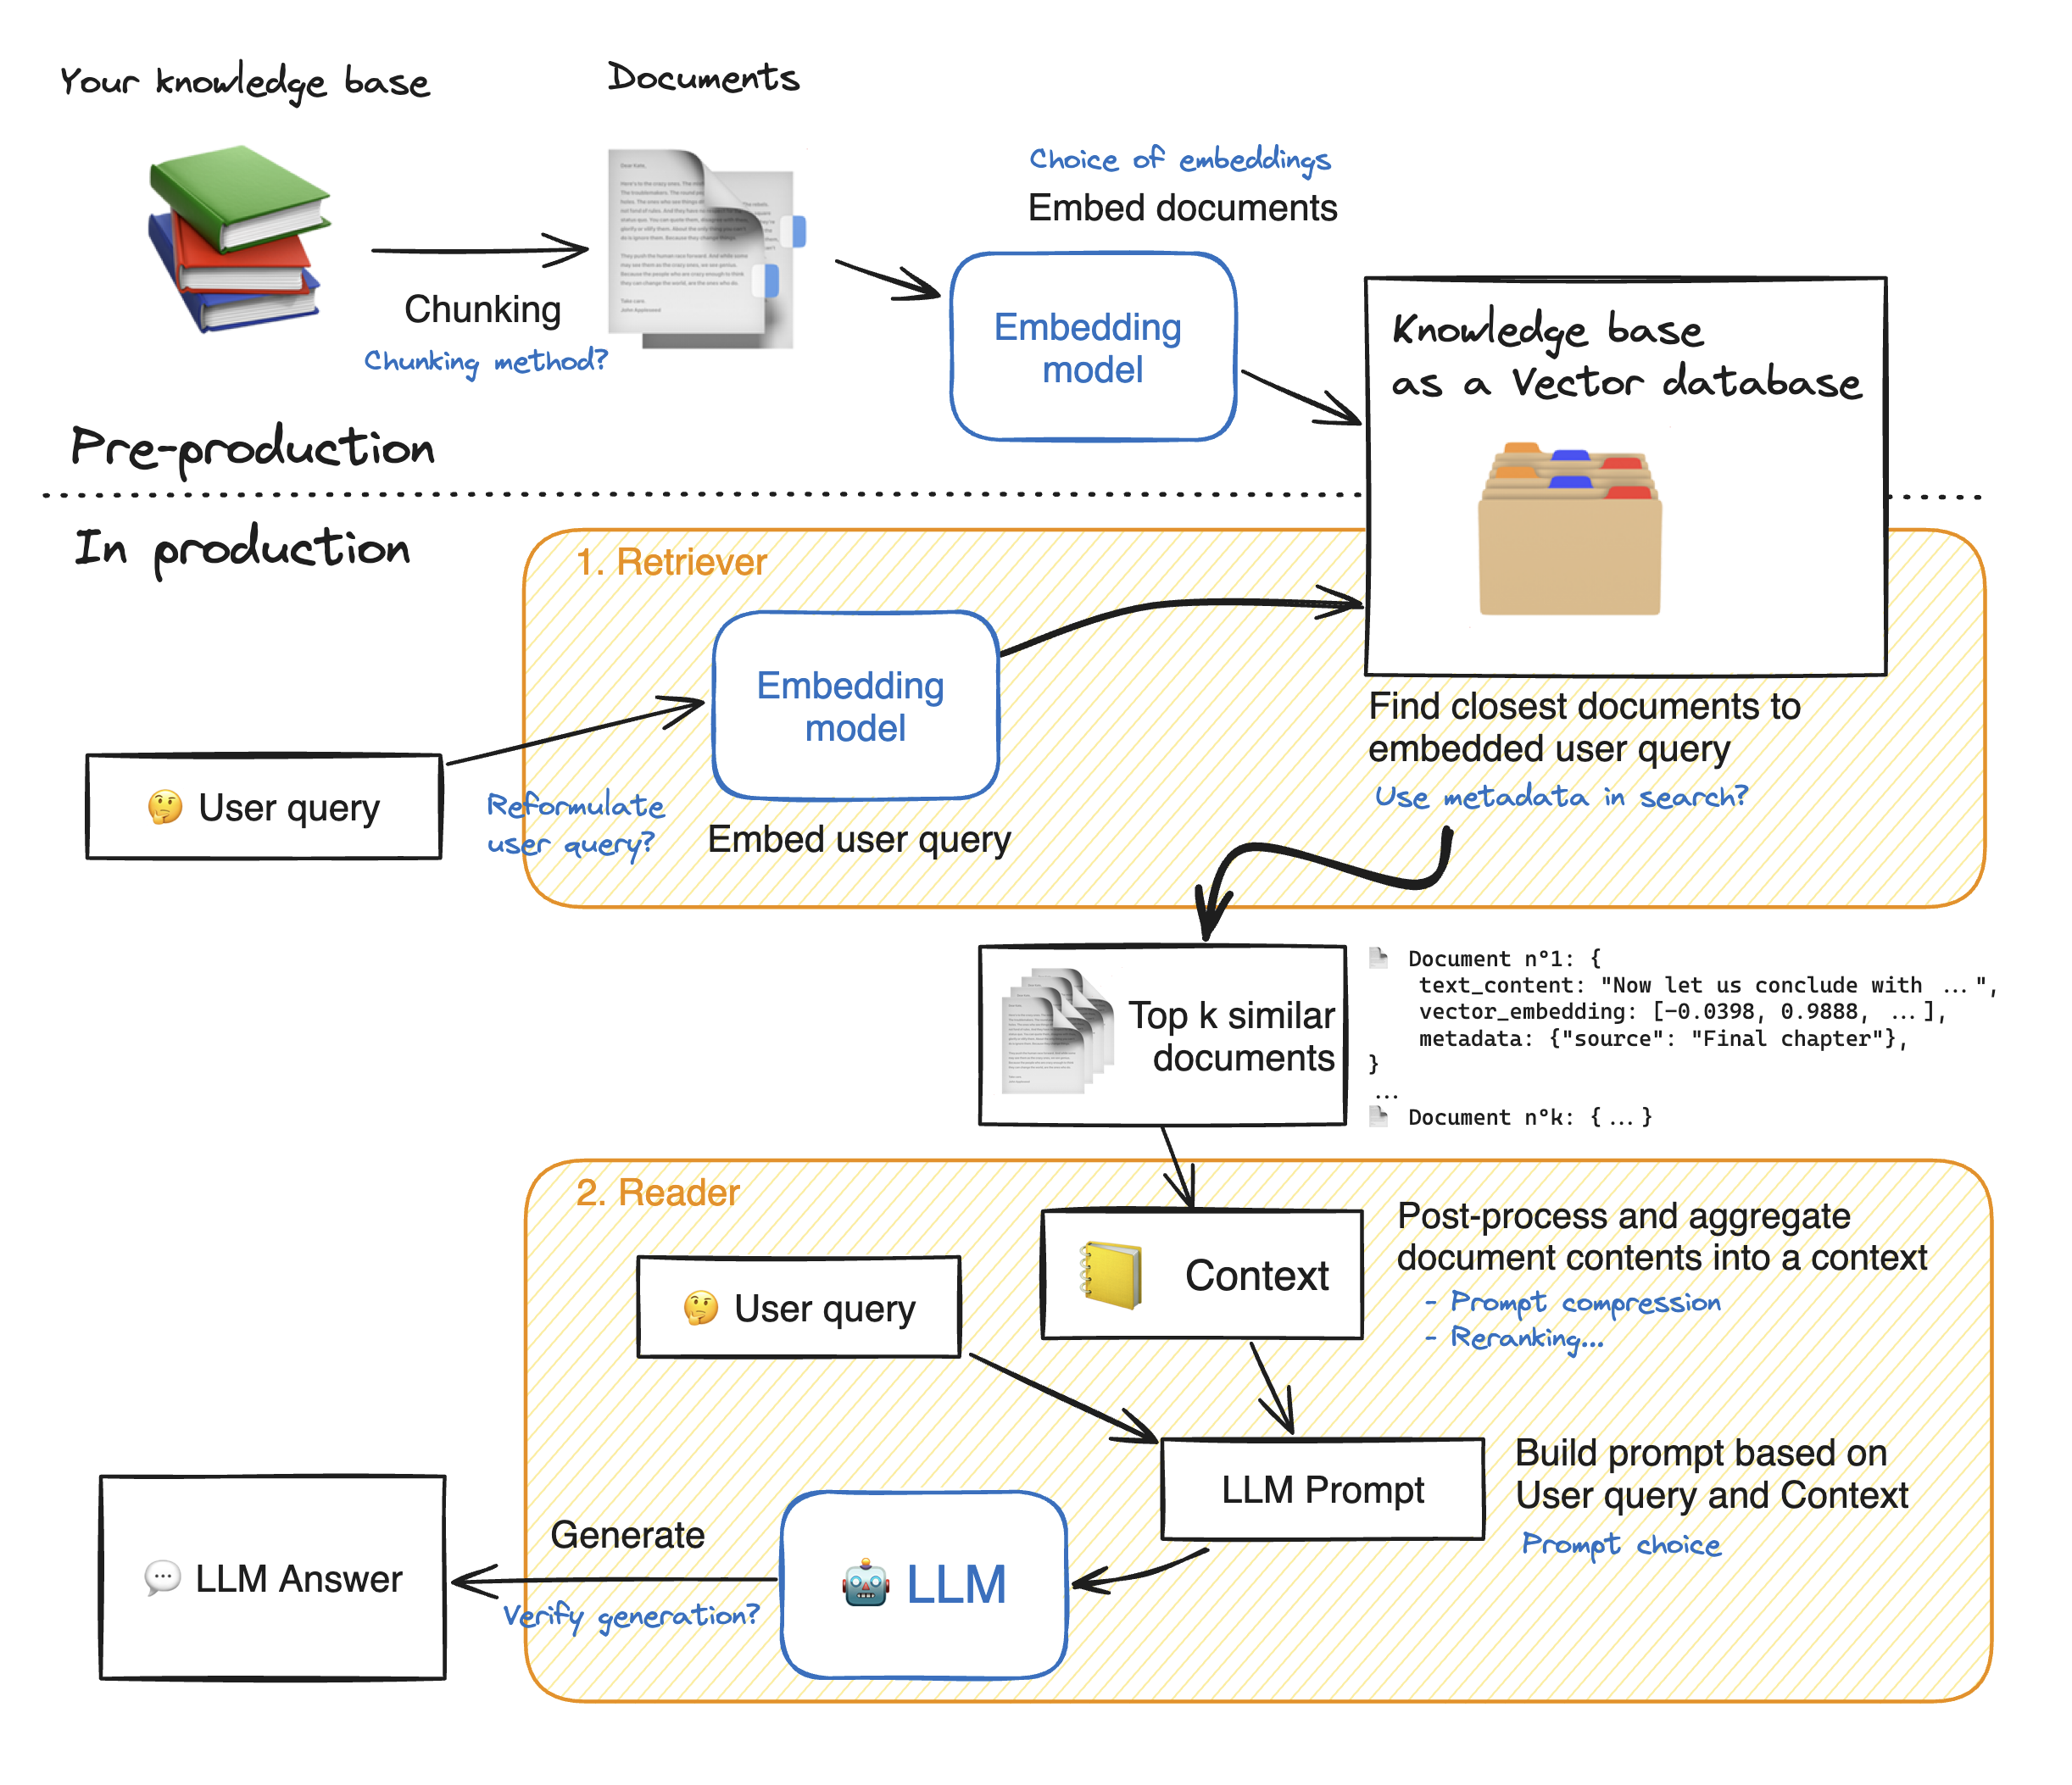
实施上述任何改进都可能会带来巨大的性能提升;但如果无法监控对系统性能的影响,那么进行任何更改都是无用的!让我们看看如何评估我们的 RAG 系统。
评估RAG性能
由于有如此多的部分需要调整,这些部分对性能有很大影响,因此对 RAG 系统进行基准测试是至关重要的。
对于我们的评估流水线,我们将需要:
- 一个带有问题-答案对的评估数据集(QA 对)
- 一个评估器,用于计算我们的系统在上面的评估数据集上的准确性。
➡️ 结果发现,我们可以在整个过程中使用 LLMs 来帮助!
- 评估数据集将由 LLM 🤖 合成生成,并且问题将由其他 LLM 🤖 过滤掉
- 然后,LLM-as-a-judge 智能体 🤖 将在这个合成数据集上执行评估。
让我们深入挖掘并开始构建我们的评估流水线! 首先,安装所需的模型依赖项。
加载你的知识基础
1. 为评估构建合成数据集
我们首先构建一个问题和相关上下文的综合数据集。方法是先从我们的知识库中获取元素,并让 LLM 根据这些文档生成问题。
然后,我们设置其他 LLM 智能体作为生成问答对的质置过滤器:每个智能体将作为一个特定缺陷的过滤器。
1.1. 准备源数据文档
1.2. 为问题生成设置智能体
我们采用 Mixtral 作为问答对的生成,因为他在各个排行榜上表现极佳,比如 Chatbot Arena。
现在让我们生成我们的问答对。
对于这个例子,我们只生成 10 个问答对,并从 Hub 加载其余的。
但是对于你的特定知识库,考虑到你想要获得至少约 100 个测试样本,并且考虑到我们稍后会用我们的批判智能体过滤掉大约一半的样本,你应该生成更多的样本,超过 200 个。
1.3. 设置批判智能体
之前的智能体生成的问题可能存在许多缺陷:在验证这些问题之前,我们应该进行质量检查。
因此,我们构建了批判智能体,它们将根据以下几个标准对每个问题进行评分,这些标准在这篇论文中给出:
- 具体性(Groundedness):问题是否可以从给定的上下文中得到回答?
- 相关性(Relevance):问题对用户是否相关?例如,
"transformers 4.29.1 发布的日期是什么?"对于 ML 用户来说并不相关。
我们注意到的一个最后的失败案例是,当一个函数是为生成问题的特定环境量身定做的,但本身难以理解,比如"这个指南中使用的函数的名称是什么?"。
我们也为这个标准构建了一个批判智能体:
- 独立(Stand-alone):对于一个具有领域知识/互联网访问权限的人来说,问题在没有任何上下文的情况下是否可以理解?与此相反的是,对于从特定博客文章生成的问题比如"这篇文章中使用的函数是什么?"
我们系统地用所有这些智能体对函数进行评分,每当任何一个智能体的分数太低时,我们就从我们的评估数据集中删除这个问题。
💡 当要求智能体输出分数时,我们首先要求它们产生其理由。这将帮助我们验证分数,但最重要的是,要求它首先输出理由给了模型更多的 token 来思考和详细阐述答案,然后再将其总结成一个单一的分数 token。
我们现在构建并运行这些批判智能体。
现在让我们基于我们批判智能体的分数过滤掉不好的问题:
Evaluation dataset before filtering:
============================================
Final evaluation dataset:
现在我们合成评估数据集已完成!我们可以在这个评估数据集上评估不同的 RAG 系统。
我们在这里只生成了少数几个问答对,以减少时间和成本。下面,让我们通过加载一个预先生成的数据集来进行下一部分:
2. 构建我们的 RAG 系统
2.1. 预处理文档来构建我们的向量数据库
- 在这一部分,我们将知识库中的文档分割成更小的片段:这些将是被检索器选取的片段,然后被阅读器 LLM 作为支持其答案的元素。
- 目标是构建语义上相关的片段:不要太小,以免不足以支持答案,也不要太大,以免稀释单个内容。
文本分割有许多选项:
- 每隔
n个单词/字符分割,但这有可能割裂段落甚至句子 - 在
n个单词/字符后分割,但只在句子边界处 - 递归分割 尝试通过树状处理文档来保留更多文档结构,首先在最大单元(章节)上分割,然后递归地在更小单元(段落,句子)上分割。 要了解更多关于分块的信息,我建议你阅读由 Greg Kamradt 编写的不错的教程 。
这个 space 让你可视化不同的分割选项是如何影响你得到的片段的流程。
在以下内容中,我们使用 Langchain 的
RecursiveCharacterTextSplitter。 💡 为了在我们的文本分割器中测量片段长度,我们的长度函数将不是字符的数量,而是 token 化文本中的 token 数量:实际上,对于后续处理 token 的嵌入器来说,以 token 为单位测量长度更为相关,并且在经验上表现更好.
2.3. 阅读器 - LLM 💬
在这一部分,LLM 阅读器读取检索到的文档以形成其答案。
🛠️ 为了改善结果,我们尝试了以下选项:
- 切换重排序开启或关闭的状态
- 更改阅读器模型
3. 对 RAG 系统进行基准测试
RAG 系统和评估数据集现在准备好了。最后一步是在这个评估数据集上判断 RAG 系统的输出。 为此,我们设置了一个裁判智能体。 ⚖️🤖
在不同的 RAG 评估指标中,我们选择只关注忠实度,因为这是衡量我们系统性能的最佳的端到端指标。
我们使用 GPT4 作为评判者,因为它在实际应用中表现良好,但你也可以尝试其他模型,例如 kaist-ai/prometheus-13b-v1.0 或 BAAI/JudgeLM-33B-v1.0。
💡 在评估提示中,我们给出了每个指标的详细描述,采用 1-5 分的评分刻度,正如 Prometheus 的提示模板 所做的那样:这有助于模型精确地确定其指标。如果你给评判 LLM 一个模糊的评分刻度,那么不同示例之间的输出将不够一致。
💡 再次提示 LLM 在给出最终评分之前先输出其理由,这样它就有更多的 token 来帮助它正式化和详细阐述评判。
🚀 让我们运行一下测试和评估一下答案!👇
检查结果
settings
,./output/rag_chunk:200_embeddings:thenlper~gte-small_rerank:False_reader-model:zephyr-7b-beta.json       0.884328
,./output/rag_chunk:200_embeddings:BAAI~bge-base-en-v1.5_rerank:False_reader-model:zephyr-7b-beta.json    0.906716
,./output/rag_chunk:200_embeddings:BAAI~bge-base-en-v1.5_rerank:True_reader-model:zephyr-7b-beta.json     0.906716
,./output/rag_chunk:200_embeddings:thenlper~gte-small_rerank:True_reader-model:mixtral.json               0.906716
,./output/rag_chunk:200_embeddings:thenlper~gte-small_rerank:True_reader-model:zephyr-7b-beta.json        0.921642
,./output/rag_chunk:200_embeddings:thenlper~gte-small_rerank:True_reader-model:mixtral0.json              0.947761
,Name: eval_score_GPT4, dtype: float64
结果示例
让我们加载通过调整这个 notebook 中可用的不同选项所获得的结果。关于这些选项为何有效或无效的更多细节,请参阅 高级 RAG 的 notebook。
正如在下面的图表中所看到的,一些调整并没有带来任何改善,而有些则带来了巨大的性能提升。
➡️ 所以没有单一的好方法:在调整你的 RAG 系统时,应该尝试几种不同的方向。
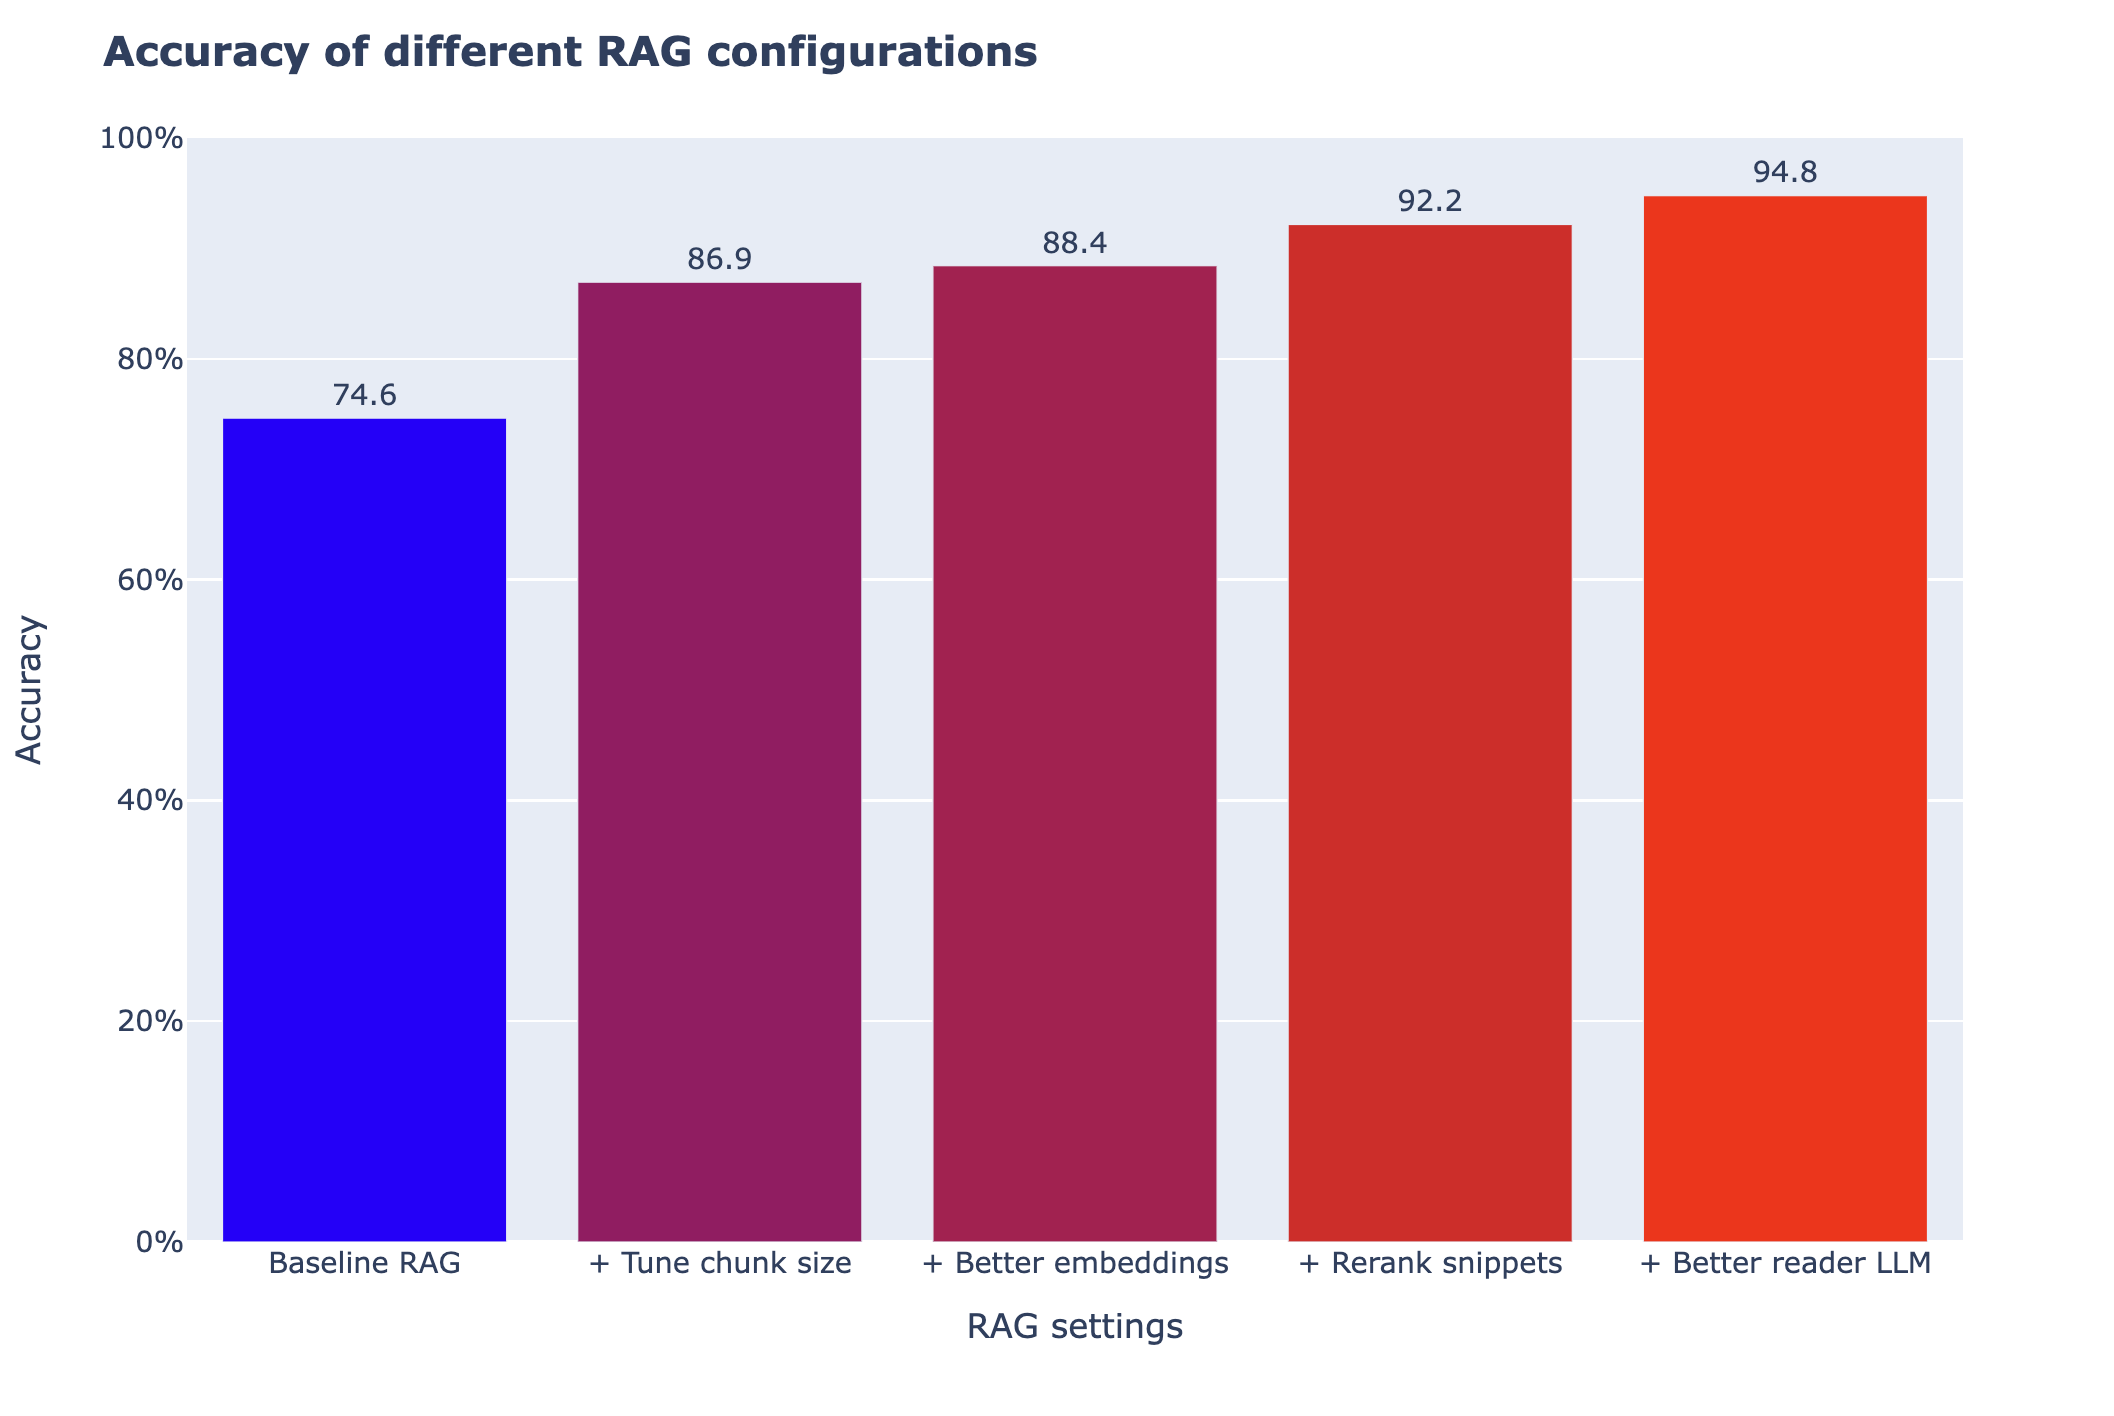
如上图所示,这些调整对性能的影响各不相同。尤其是调整片段大小,既简单又非常有影响力。
但这只是针对我们的情况:你的结果可能大不相同:现在你已经有了一个可靠的评估流水线,可以开始探索其他选项了!🗺️