
Automatic Embedding Tei Inference Endpoints
怎么使用推理端点去嵌入文档
作者: Derek Thomas
目标
我有一个数据集,我想为其嵌入语义搜索(或问答,或 RAG),我希望以最简单的方式嵌入这个数据集并将其放入一个新的数据集中。
方法
我将使用我最喜欢的 subreddit r/bestofredditorupdates 中的数据集。因为它有很长的条目,同时使用新的 jinaai/jina-embeddings-v2-base-en 嵌入模型,因为它有 8k 的上下文长度。还将使用 推理端点 部署这个,以节省时间和金钱。要跟随这个教程,你需要已经添加了支付方式。如果你还没有添加,可以在 账单 中添加。为了使操作更加简单,我将完全基于 API 进行操作。
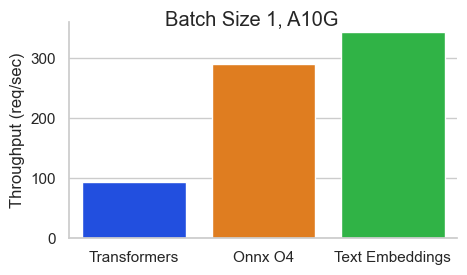
为了使这个过程更快,我将使用 Text Embeddings Inference 镜像。这有许多好处,比如:
- 无需模型图编译步骤
- Docker 镜像小,启动时间快。真正的无服务器!
- 基于 token 的动态批处理
- 使用 Flash 注意力机制、Candle 和 cuBLASLt 优化的 transformers 代码进行推理
- Safetensors 权重加载
- 生产就绪(使用 Open Telemetry 进行分布式跟踪,Prometheus 指标)
环境(Requirements)
导入包
设置(Config)
DATASET_IN 你文本数据的位置
DATASET_OUT 你的嵌入储存的位置
注意:我将 MAX_WORKERS 设置为 5,因为 jina-embeddings-v2 对内存的需求较大。
Hugging Face 在推理端点中提供了多种 GPU 供选择。下面以表格形式呈现:
| GPU | 实例类型 | 实例大小 | vRAM |
|---|---|---|---|
| 1x Nvidia Tesla T4 | g4dn.xlarge | small | 16GB |
| 4x Nvidia Tesla T4 | g4dn.12xlarge | large | 64GB |
| 1x Nvidia A10G | g5.2xlarge | medium | 24GB |
| 4x Nvidia A10G | g5.12xlarge | xxlarge | 96GB |
| 1x Nvidia A100* | p4de | xlarge | 80GB |
| 2x Nvidia A100* | p4de | 2xlarge | 160GB |
*注意,对于 A100 的机型你需要发邮件给我们来获取权限。
VBox(children=(HTML(value='<center> <img\nsrc=https://huggingface.co/front/assets/huggingface_logo-noborder.sv…
有些用户可能会在组织中注册支付信息。这肯能会使你的支付方式链接组织。
如果你想使用你自己的用户名,请将其留空。
What is your Hugging Face 🤗 username or organization? (with an added payment method) ········
获取数据
Downloading readme: 0%| | 0.00/1.73k [00:00<?, ?B/s]
Dataset({
,    features: ['id', 'content', 'score', 'date_utc', 'title', 'flair', 'poster', 'permalink', 'new', 'updated'],
,    num_rows: 10042
,}) (100,
, {'id': '10004zw',
, 'content': '[removed]',
, 'score': 1,
, 'date_utc': Timestamp('2022-12-31 18:16:22'),
, 'title': 'To All BORU contributors, Thank you :)',
, 'flair': 'CONCLUDED',
, 'poster': 'IsItAcOnSeQuEnCe',
, 'permalink': '/r/BestofRedditorUpdates/comments/10004zw/to_all_boru_contributors_thank_you/',
, 'new': False,
, 'updated': False}) 这里有几个设计选择:
- 像之前所说,我们使用
jinaai/jina-embeddings-v2-base-en作为我们的模型。- 为了可复现性,我们将它固定到一个特定的修订版本。
- 如果你对更多模型感兴趣,可以查看支持列表。
- 请注意,大多数嵌入模型都是基于 BERT 架构的。
MAX_BATCH_TOKENS是根据我们的工作数量和嵌入模型的上下文窗口来选择的。type="protected"利用的是推理端点详细说明的安全功能。- 我使用 1x Nvidia A10,因为
jina-embeddings-v2对内存的需求很大(记住 8k 的上下文长度)。 - 如果你有高工作负载的需求,你应该考虑进一步调整
MAX_BATCH_TOKENS和MAX_CONCURRENT_REQUESTS。
等待直到它运行起来
CPU times: user 48.1 ms, sys: 15.7 ms, total: 63.8 ms
Wall time: 52.6 s
InferenceEndpoint(name='boru-jina-embeddings-demo-ie', namespace='HF-test-lab', repository='jinaai/jina-embeddings-v2-base-en', status='running', url='https://k7l1xeok1jwnpbx5.us-east-1.aws.endpoints.huggingface.cloud')
当我们使用 endpoint.client.post 时,我们得到一个字节字符串。这有点繁琐,因为我们需要将这个字节字符串转换为一个 np.array,但这只是 Python 中的几行快速代码。
array([-0.05630935, -0.03560849,  0.02789049,  0.02792823, -0.02800371,
,       -0.01530391, -0.01863454, -0.0077982 ,  0.05374297,  0.03672185,
,       -0.06114018, -0.06880157, -0.0093503 , -0.03174005, -0.03206085,
,        0.0610647 ,  0.02243694,  0.03217408,  0.04181686,  0.00248854])
你可能遇到超过上下文长度的输入。在这种情况下,需要你来处理它们。在我的情况下,我更愿意截断而不是出现错误。让我们测试一下这是否有效。
The length of the embedding_input is: 300000
array([-0.03088215, -0.0351537 ,  0.05749275,  0.00983467,  0.02108356,
,        0.04539965,  0.06107162, -0.02536954,  0.03887688,  0.01998681,
,       -0.05391388,  0.01529677, -0.1279156 ,  0.01653782, -0.01940958,
,        0.0367411 ,  0.0031748 ,  0.04716022, -0.00713609, -0.00155313])
获取嵌入
在这里,我发送一个文档,用嵌入更新它,然后返回它。这是与 MAX_WORKERS 并行的发生的。
0%| | 0/100 [00:00<?, ?it/s]
Embeddings = 100 documents = 100
0 min 21.33 sec
暂停推理端点
现在我们已经完成了嵌入,让我们暂停端点,以免产生任何额外费用,同时这也允许我们分析成本。
Endpoint Status: paused
将更新后的数据集推送到 Hub
现在我们的文档已经更新了我们想要的嵌入。首先我们需要将其转换回 Dataset 格式。我发现从字典列表 -> pd.DataFrame -> Dataset 这条路径最为简单。
我默认将其上传到用户的账户(而不是上传到组织),但你可以通过在 repo_id 中设置用户或在配置中通过设置 DATASET_OUT 来自由推送到任何你想要的地方。
Pushing dataset shards to the dataset hub: 0%| | 0/1 [00:00<?, ?it/s]
Downloading metadata: 0%| | 0.00/823 [00:00<?, ?B/s]
Dataset is at https://huggingface.co/datasets/derek-thomas/processed-subset-bestofredditorupdates
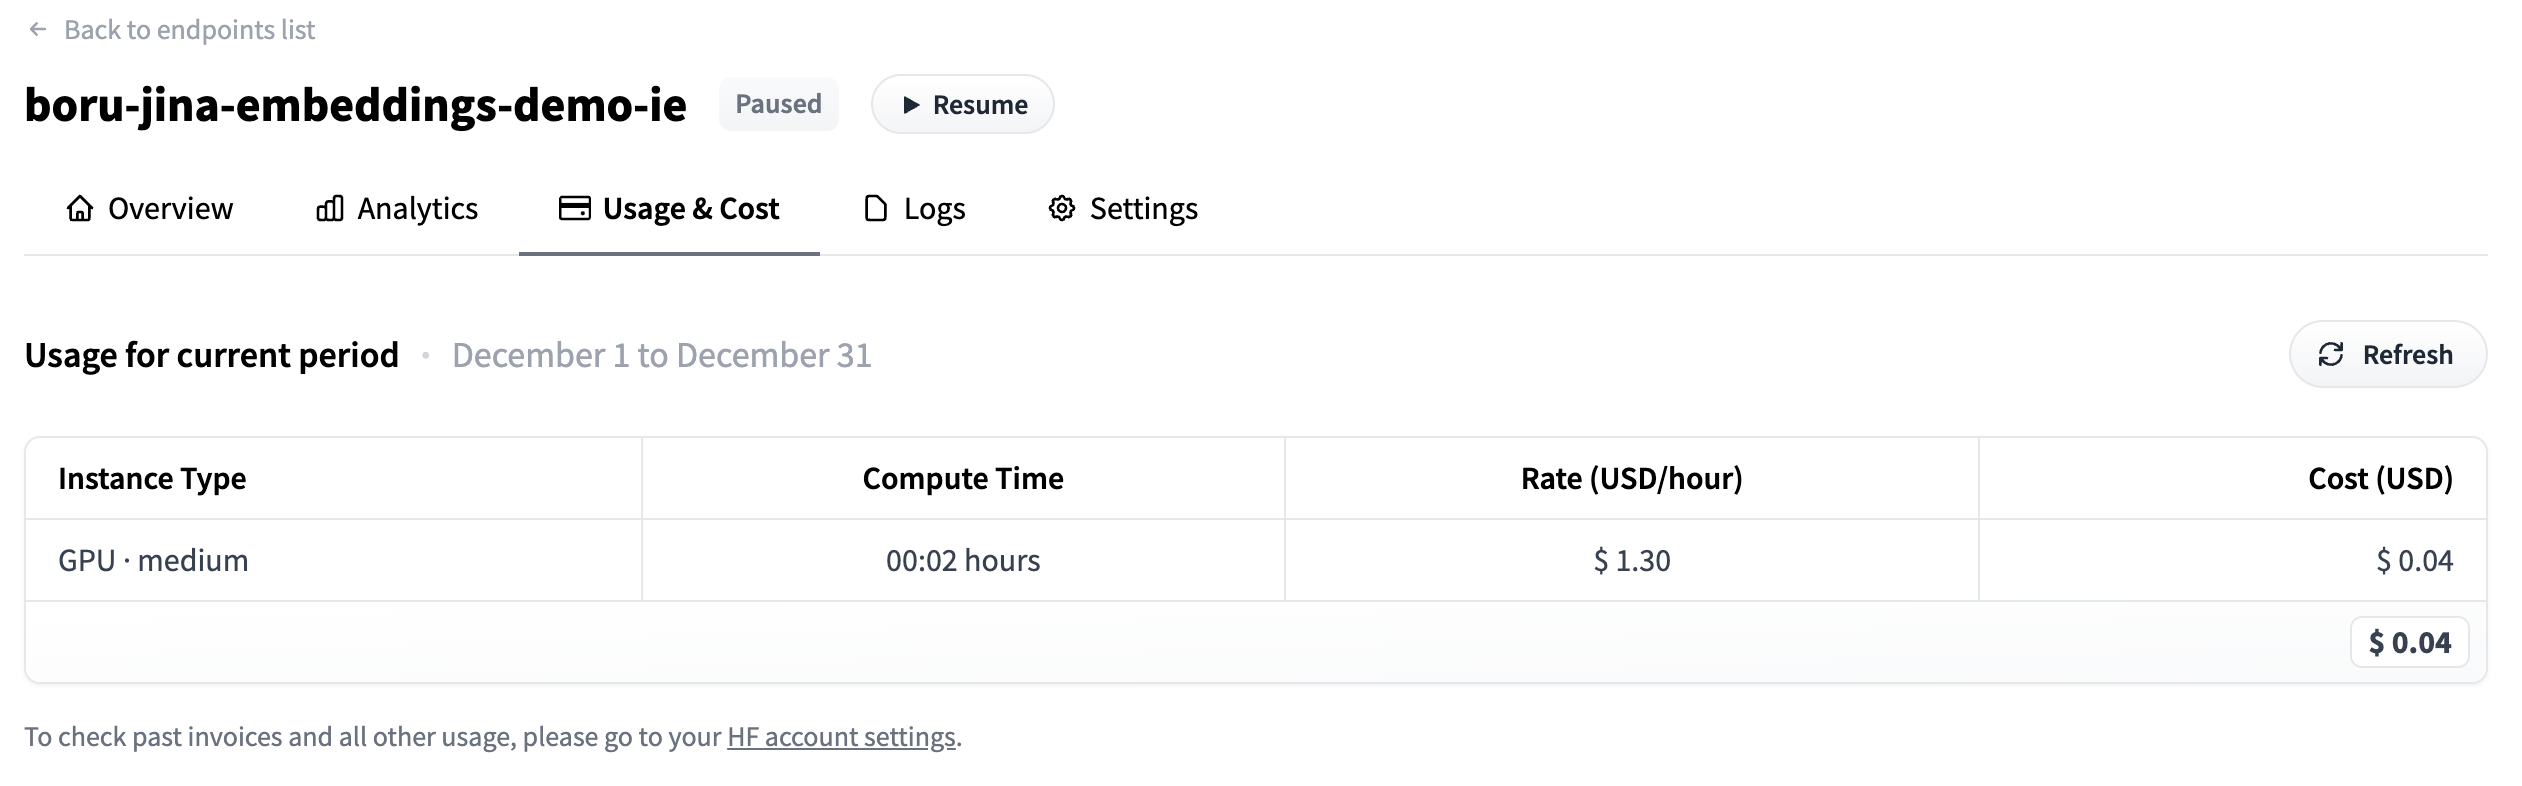
分析使用情况
- 前往下面打印的
dashboard_url - 点击使用与成本 (Usage & Cost) 标签
- 查看你已经花费了多少
https://ui.endpoints.huggingface.co/HF-test-lab/endpoints/boru-jina-embeddings-demo-ie
Hit enter to continue with the notebook
''
我们可以看到只花了 $0.04 !
删除端点
现在我们已经完成了,不再需要我们的端点了。我们可以以编程方式删除端点。
Endpoint deleted successfully